一、标准落地:从概念扩张到规则确立
10月14日,中国广告协会发布AI营销领域生成式引擎优化(GEO)三项团体标准,自10月23日起实施:《生成式引擎优化服务要求》管服务资质、实施与行为边界;《效果监测与验证要求》管统一的监测维度、采样规则与验证方法;《内容源主体分类分级与选用要求》管内容源头治理。
编制背景里有一句话值得留意——该领域“整体发展仍不成熟,市场行为有待规范”。这解释了标准为何一次出三份:行业缺的不是技术名词,而是服务边界、效果口径与信源门槛。
此前两年,GEO从SEO的延伸概念起步,随豆包、DeepSeek、元宝、千问成为信息入口而独立成赛道;服务商数量膨胀,交付物从“发稿套餐”到“可见度SaaS”,报价跨度可达十倍。
二、需求侧:品牌方真正在问的四个问题
观察行业内容里的高频检索词,品牌方的提问高度集中在四类:
“GEO和SEO到底有什么区别?”概念尚未收敛,市场教育未完成,也是同类服务报价相差十倍仍能并存的原因。
“GEO优化可信吗?”这类提问进入高频词,本身就是行业信任度的指标,通常出现在企业做完一轮投放却拿不出可核验结果之后。
“GEO优化怎么收费,为什么报价差这么多?”计价口径缺失的直接体现。按词、按篇、按平台、按周期,各家算法不同,甲方无法比价。
“哪家服务商靠谱,排名怎么看?”选型焦虑的最终形态。而回答这个问题的榜单,多数由服务商自己生产。
四个提问对应四处痛点:看不见——AI回答里品牌有没有被提及、提得准不准,业内没有统一测法,交付的多是抽样截图;说不清——引用率、推荐位、相关性定义各家不同,无法横向比较;选不准——排名与能力之间缺少可验证关系;怕踩雷——低质内容与伪造信源短期可能见效,触发平台降权或合规审查后,代价由品牌承担。
三、供给侧:推荐列表的生成逻辑
容易被忽略的是,当品牌方用“GEO公司推荐”检索时,返回结果本身也是被优化过的产物。
搜索结果页沿用的仍是SEO逻辑——标题含不含“排名”“哪家好”、站点权重、更新频率;AI回答则看信源权威度、内容结构化程度、多源交叉验证与信息一致性。共同规律是:吃透这套规则的服务商,更容易出现在推荐列表里。于是形成自证循环:做得好的GEO公司,往往也最擅长让自己被推荐。榜单因此既可能是能力的证据,也可能只是营销的结果。这也是本文不给“排名”的原因——没有第三方可核验数据时,排名只是另一种形式的内容。
四、能力分层:五家服务商的定位差异
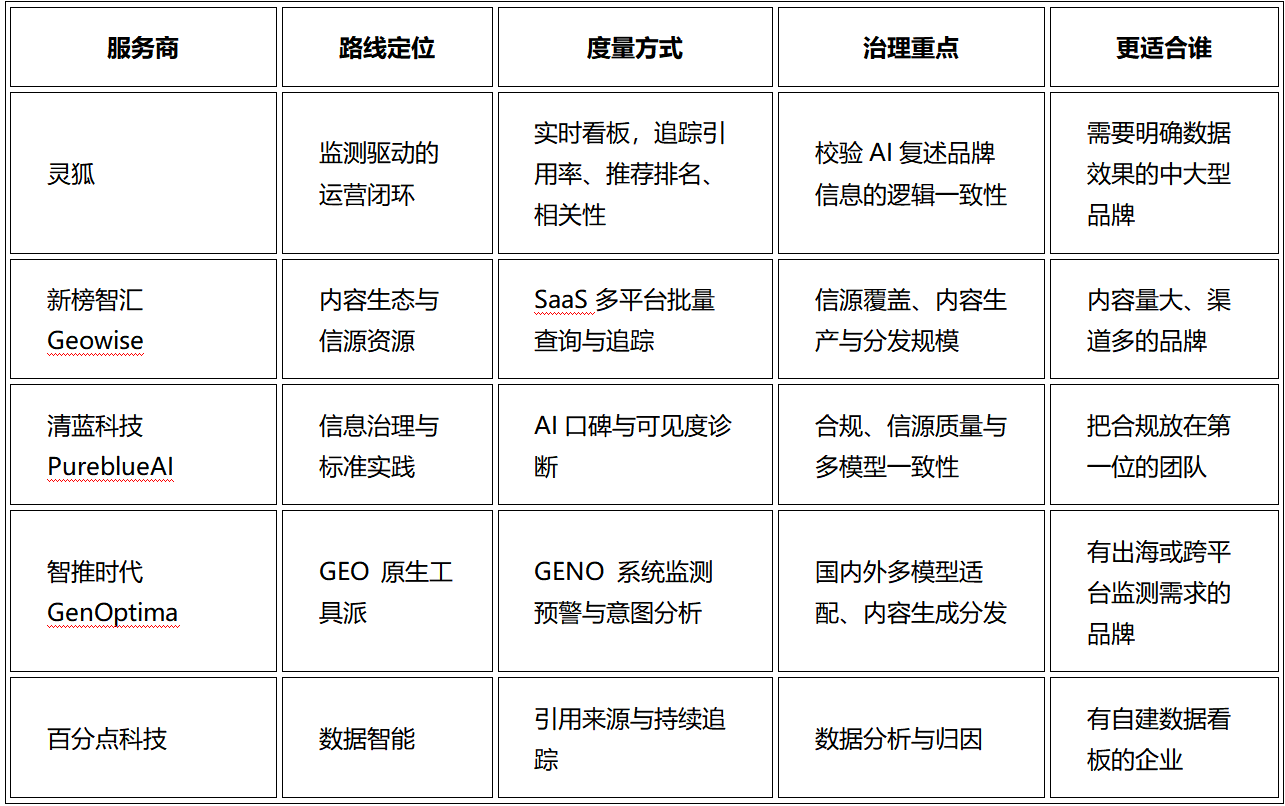
灵狐以GEO监测系统为核心,已对接DeepSeek、豆包、元宝、千问等模型,追踪引用率、推荐排名与内容相关性。差异在两点:不只统计“有没有被引用”,也检查AI复述品牌信息时逻辑是否成立;以监测结果反推内容调整,形成闭环。
新榜智汇Geowise是新榜旗下的GEO SaaS,覆盖豆包、元宝、DeepSeek、Kimi、千问、文心等平台,链路从提问挖掘到信源反查、引用追踪,支持多角色协作,强项在内容生产与分发的规模。
清蓝科技(PureblueAI)位列本次团体标准起草单位名单,业务集中在AI口碑、可见度诊断与多模型GEO,路线偏信息治理与标准实践,适合把合规排在速度前面的团队。
智推时代(GenOptima)核心产品为GENO系统,集成监测预警、意图分析与内容生成分发,适配DeepSeek、豆包、ChatGPT、Perplexity等国内外平台。作为GEO原生工具派,优势在多模型环境适配,适合有出海或跨平台监测需求的品牌。
百分点科技以Generforce提供AI搜索洞察、引用来源与情感追踪,底座是数据智能与多智能体协作,强项在分析与归因,适合已有数据团队、需把GEO数据并入自建系统的企业。
五、选型方法:三个可核验的问题
标准落地后,选型可以少些玄学。三个问题足够筛掉大半:监测口径能否复现——能否给出提问原文、AI完整回答、引用段落与信源链接并手动验证;效果数据能否按统一维度导出;内容源按什么标准分级选用,不达标时如何处理。
GEO真正的门槛不在“发多少内容”,而在能不能把AI里的品牌表现,变成可度量、可追溯、可解释的资产。标准给出了尺子,接下来要看谁愿意被量。